پژوهش ReplaySSM؛ تولید متن در مدلهای ترکیبی چه زمانی سریعتر میشود؟
ReplaySSM نگهداری دادههای میانی مدلهای ترکیبی را تغییر میدهد؛ نتایج پژوهش نشان میدهد افزایش سرعت به تعداد درخواستها و شرایط اجرا وابسته است.
در این مقاله میخوانید ۲ بخش
تغییر در اجرای مدل، نه عرضه یک چتبات
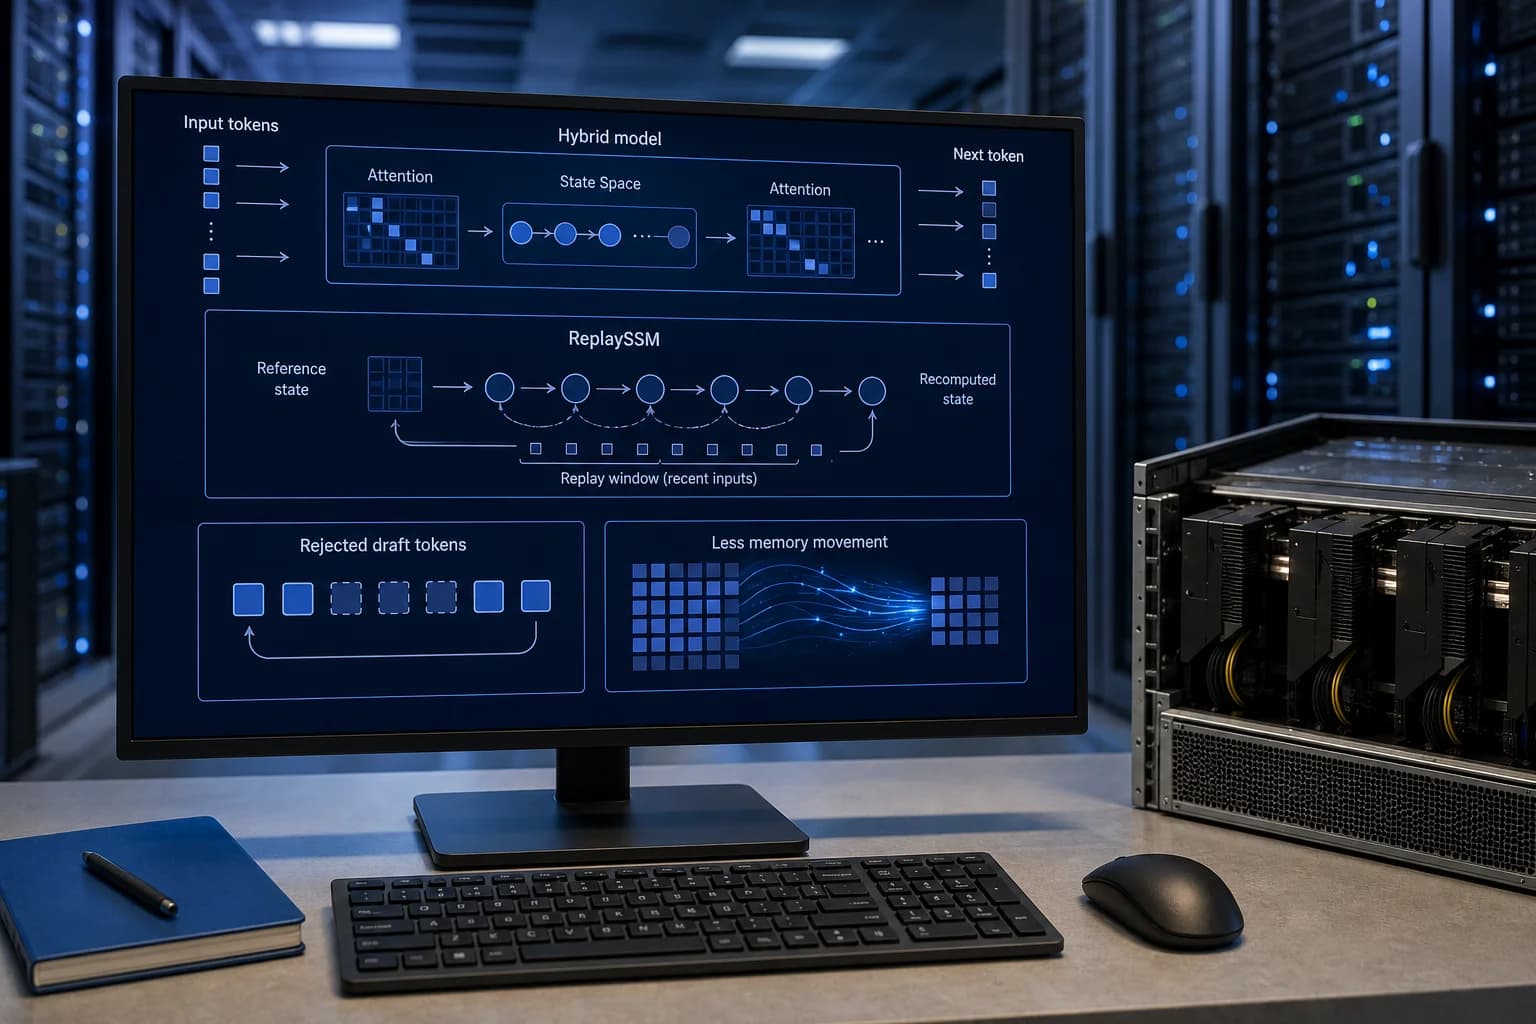
پژوهش ReplaySSM روشی برای سریعترکردن تولید متن در مدلهای ترکیبی معرفی میکند، اما در آزمایش تکدرخواستی افزایش سرعتی نشان نداده است. نسخه نخست مقاله در ۹ اکتبر ۲۰۲۶ در arXiv ثبت شد؛ انویدیا گزارش فنی آن را در ۱۲ اکتبر منتشر کرد. این رویداد عرضه یک مدل مصرفکننده نیست.
روش پیشنهادی بهجای نوشتن وضعیت کامل لایههای فضای حالت در هر گام، یک وضعیت مرجع و ورودیهای اخیر را نگه میدارد. هدف، کاهش جابهجایی داده در حافظه و سادهترکردن بازگشت از توکنهای پیشنهادیِ ردشده است؛ یعنی تغییر در زیرساخت اجرای مدل، نه افزودن قابلیت تازه به چتبات.
اعداد سرعت را با شرایط آزمایش بخوانیم
پژوهشگران چهار مدل Nemotron-3-Nano-4B، Nemotron-3-Super-120B-A12B، Qwen3.5-4B و Qwen3.5-122B-A10B را بررسی کردند. دو مدل چهارمیلیاردپارامتری روی یک H100 و دو مدل بزرگتر روی یک B300 اجرا شدند؛ مدلها میان چند پردازنده گرافیکی تقسیم نشدند.
در دسته ۲۵۶درخواستی، سرعت هسته محاسباتی ۱٫۴۶ تا ۱٫۸۰ برابر شد، اما سرعت کل گام تولید توکن فقط ۱٫۲۰ تا ۱٫۴۷ برابر بود. مبنای مقایسه، اجرای تنظیمشده vLLM بود؛ آزمایشها وضعیت بازگشتی را با دقت FP32 و پنجره بازپخش ۱۶ نگه میداشتند.
این اعداد ارزیابی خود پژوهشگراناند، نه آزمون مستقل. تفاوت سرعت هسته با سرعت کل، و نبود افزایش سرعت در حالت تکدرخواستی، نشان میدهد نتیجه را نباید به سریعترشدن تضمینی چتباتها یا همه سختافزارها تعمیم داد.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.