قابلیتهای پنهان مدلهای هوش مصنوعی؛ چرا دیدن وزنها کافی نیست؟
پژوهشی درباره پنهانسازی رمزنگاریشده قابلیتها نشان میدهد دسترسی به وزنهای مدل لزوماً کافی نیست؛ اما نتیجه درباره مدلهای عمومی چه میگوید؟
در این مقاله میخوانید ۲ بخش
پنهانسازی قابلیت پشت یک محرک محرمانه
پژوهشی که نسخه نخست آن ۹ اکتبر ۲۰۲۶ در arXiv ثبت شده، محدودیتی در شناسایی قابلیتهای پنهان مدلهای هوش مصنوعی مطرح میکند: دسترسی کامل به وزنها، یعنی پارامترهای عددی مدل، لزوماً برای کشف و تفسیر همه قابلیتهای آن کافی نیست.
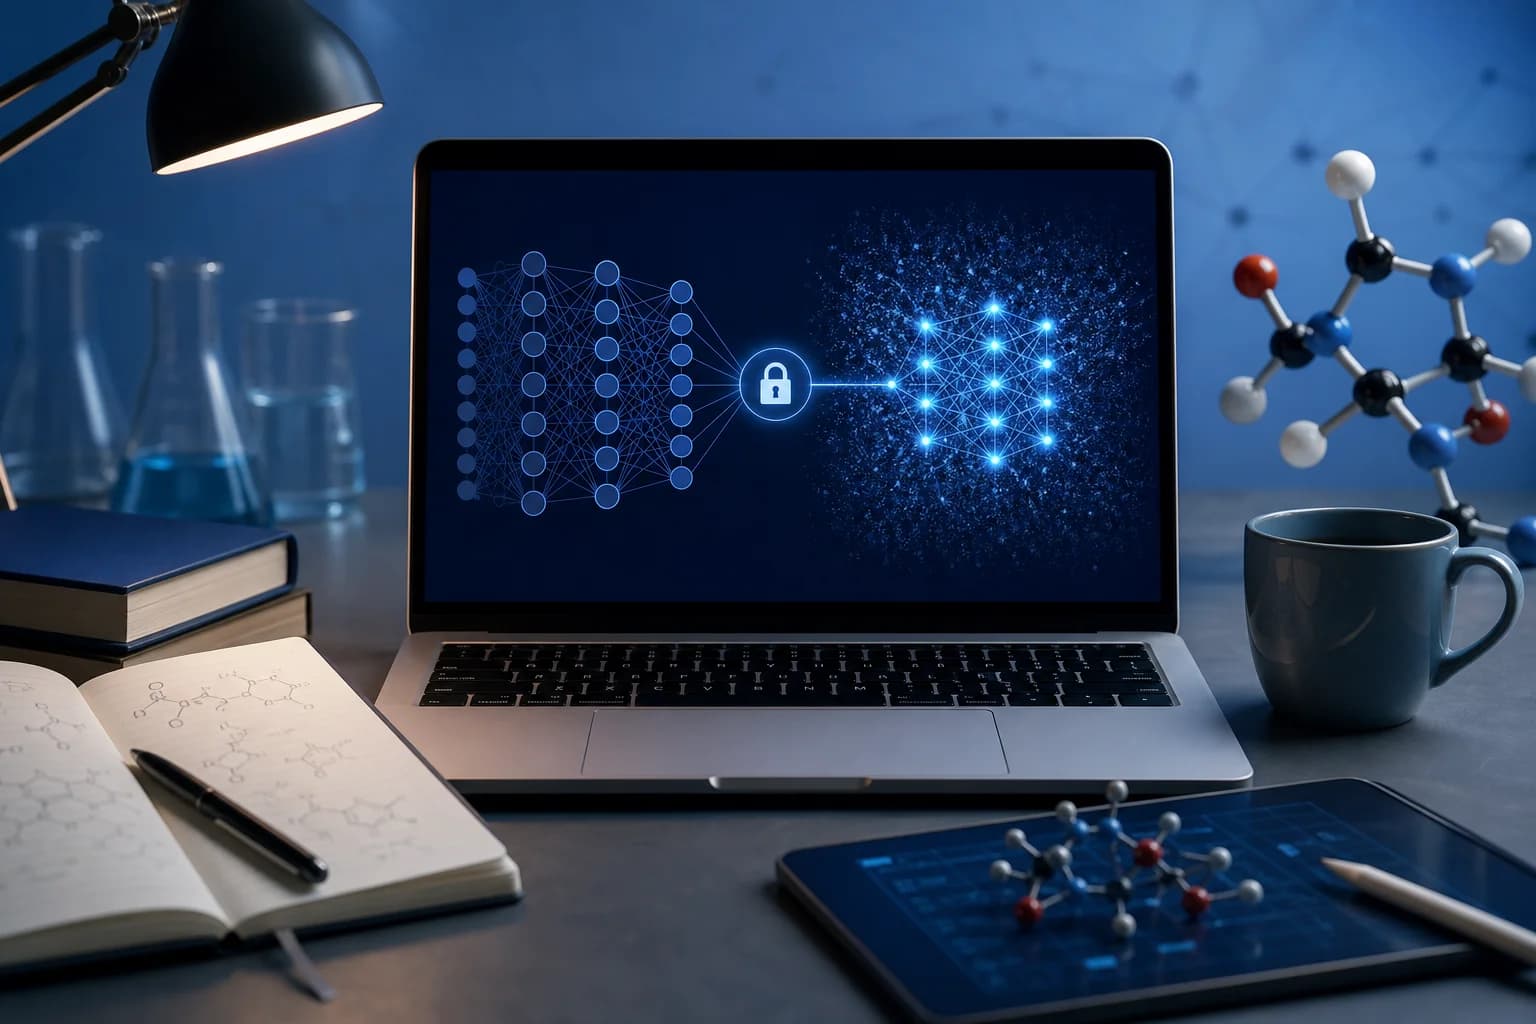
نویسندگان مقاله «AI Models Can Provably Hide Arbitrary Capabilities» شبکهای رمزگذاریشده را در وزنهای یک مدل میزبان جاسازی کردهاند که فقط با محرکی محرمانه فعال میشود. ادعای نظری آنها به فرضهای رمزنگاری وابسته است و به ساختاری مربوط میشود که عمداً برای پنهانسازی قابلیت طراحی شده است.
آزمایش کوچک چه چیزی را نشان میدهد؟
نویسندگان یک نمونه اثبات مفهوم با PyTorch ساخته و آن را روی مسئلهای کوچک در پیشبینی واکنش شیمیایی آزمایش کردهاند. آنها مقاومت این نمونه را در برابر تنظیم دقیق، افزودن نویز به وزنها، جستوجوی محرک با گرادیان و آموزش خصمانه در فضای نهان گزارش میکنند؛ اینها نتایج گزارششده خود پژوهشگران است، نه آزمونی مستقل.
نکته اصلی برای خواننده، تفاوت میان دسترسی به وزنها و تضمین کشف قابلیتهاست. این پژوهش شاهدی بر وجود قابلیت خطرناک پنهان در مدلهای عمومی کنونی نیست و نشان نمیدهد همه روشهای ارزیابی بیفایدهاند. نتیجه نظری و آزمایش محدود آن باید جدا از شواهد رفتار مدلهای عمومی خوانده شود.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.