توکن در هوش مصنوعی چیست؟ تمرین شمارش متن فارسی
با یک تمرین ساده، تعداد کلمه و توکن متن فارسی را جدا ثبت کنید؛ نام مدل، روش شمارش و تفاوت اندازه ورودی با مصرف واقعی درخواست را بشناسید.
در این مقاله میخوانید ۵ بخش
چرا تعداد کلمه، تعداد توکن نیست؟
توکن در هوش مصنوعی واحدی است که مدل برای پردازش متن به کار میبرد؛ این واحد الزاماً یک کلمه کامل نیست. طبق راهنمای OpenAI، توکن ممکن است یک نویسه، بخشی از کلمه، یک کلمه یا علامت نگارشی باشد. فاصلهها نیز در تقسیمبندی متن اثر دارند.
پس برای فهم طول یک متن فارسی، شمردن کلمهها کافی نیست. تعداد توکن به مدل، رمزگذاری و زبان وابسته است؛ نسبتهای تقریبی کلمه به توکن که راهنمای OpenAI برای انگلیسی آورده، قاعدهای برای فارسی نیستند.
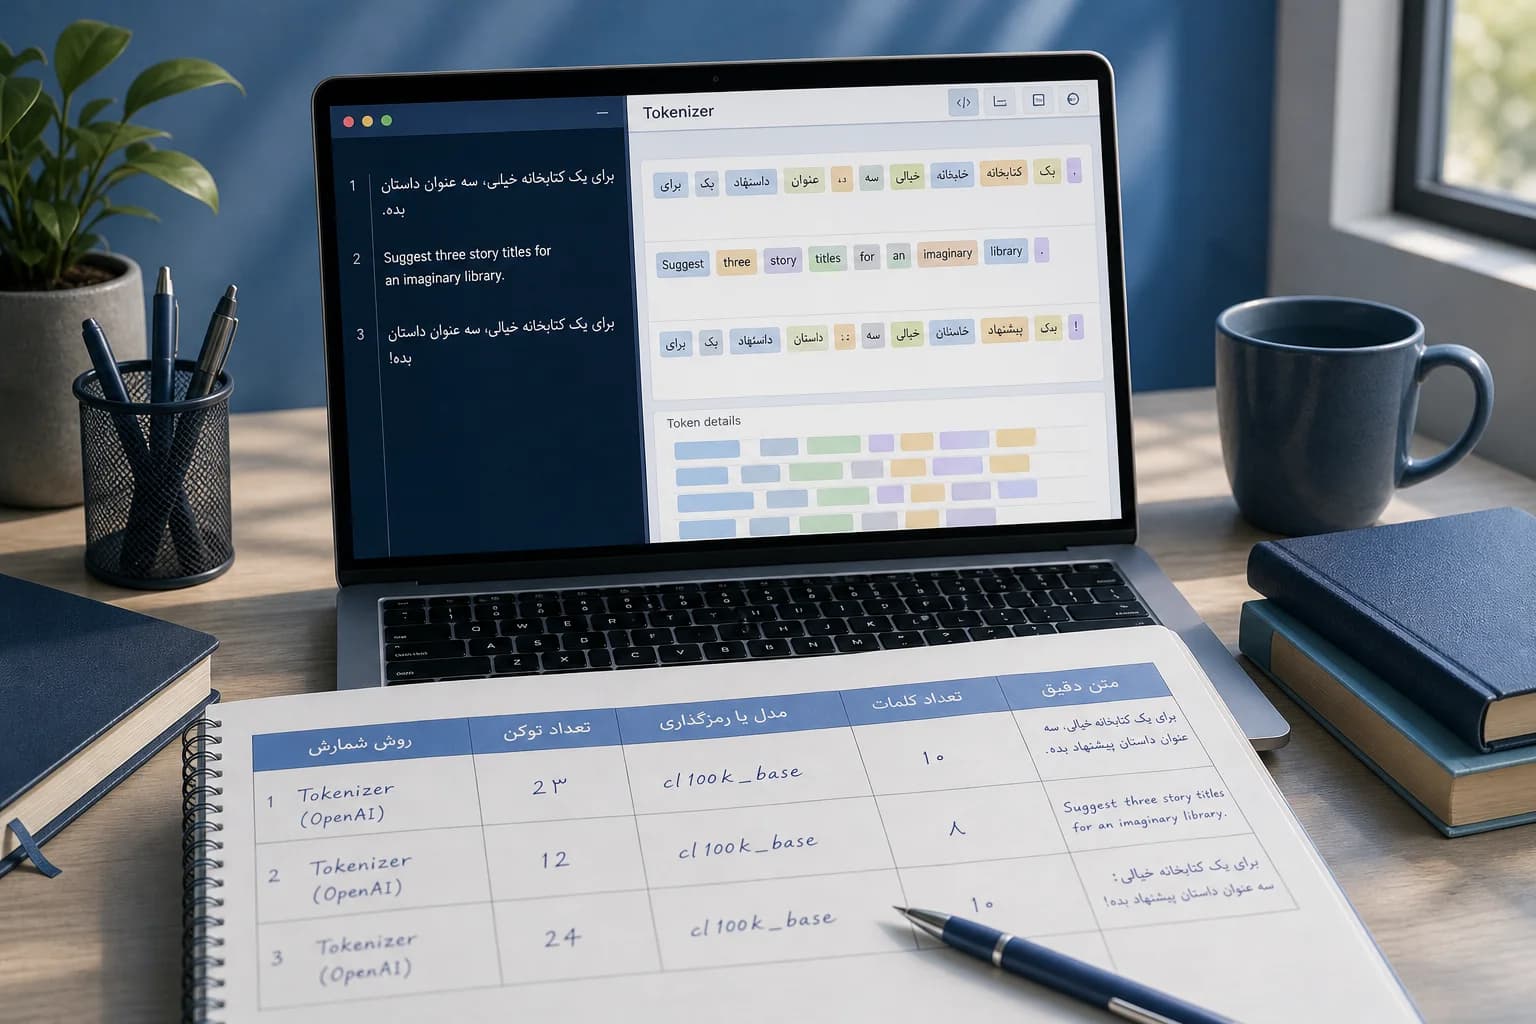
در این تمرین، یک برگه میسازید که متن دقیق، تعداد کلمه، مدل یا رمزگذاری، تعداد توکن و روش شمارش را کنار هم نگه میدارد. نتیجه، اندازهگیری چند متن مشخص است؛ نه فرمولی عمومی برای همه متنهای فارسی.
پیشنیازها و آمادهسازی برگه
برای مسیر اصلی، به یک ویرایشگر متن و دسترسی به ابزار Tokenizer معرفیشده در راهنمای رسمی OpenAI نیاز دارید. این تمرین به تولید پاسخ از مدل وابسته نیست. مسیر اختیاری Gemini به دسترسی جداگانه به Gemini API و محیط اجرای SDK نیاز دارد؛ آن را با برنامه مصرفکننده Gemini یکی نگیرید.
۱) یک فایل متنی بسازید و برای هر نمونه این پنج فیلد را در نظر بگیرید: «متن دقیق»، «تعداد کلمات»، «مدل یا رمزگذاری»، «تعداد توکن» و «روش شمارش».
۲) برای شمارش کلمات، قرارداد تمرین را بنویسید: هر قطعه جداشده با فاصله معمولی را یک واحد بشمارید. این قرارداد ساده، تعریف زبانشناختی کلمه نیست؛ هدفش تکرارپذیرکردن تمرین است. نیمفاصله را بیدلیل به فاصله تبدیل نکنید.
۳) برای تعداد توکن، تا پیش از اندازهگیری چیزی ننویسید. از روی تعداد کلمه یا ظاهر جمله عدد حدس نزنید.
سه متن را جداگانه اندازه بگیرید
۴) نمونه پرامپت پیشنهادی و آزمایشنشده زیر را در برگه ثبت کنید: برای یک کتابخانه خیالی، سه عنوان داستان پیشنهاد بده.
این متن فقط ماده تمرین است؛ برای شمارش توکن لازم نیست از مدل بخواهید به آن پاسخ بدهد. آن را در ابزار Tokenizer بررسی کنید و تعداد توکن، نام مدل یا رمزگذاری مشخصشده در ابزار و روش شمارش را یادداشت کنید. اگر مشخصات رمزگذاری معلوم نیست، «نامعلوم» بنویسید؛ نام یک مدل را خودسرانه به نتیجه نسبت ندهید.
۵) یک ردیف برای ترجمه پیشنهادی انگلیسی بسازید: Suggest three story titles for an imaginary library.
۶) یک ردیف دیگر برای نسخهای با نشانهگذاری متفاوت بسازید: برای یک کتابخانه خیالی: سه عنوان داستان پیشنهاد بده!
هر سه متن را جداگانه و با همان روش بررسی کنید. عددهای واقعی را ثبت کنید، حتی اگر برخلاف انتظار شما برابر باشند. از یک نمونه نمیتوان نتیجه گرفت فارسی همیشه نسبت مشخصی از انگلیسی توکن بیشتری مصرف میکند.
اگر از Gemini API استفاده میکنید
مستندات گوگل، count_tokens را برای سنجش ورودی پیش از اجرای درخواست معرفی میکند. در این مسیر، نام مدل را کنار نتیجه ثبت کنید و برای مقایسه متنها، مدل را ثابت نگه دارید. عدد حاصل از رمزگذار OpenAI را جای شمارش همان متن برای Gemini نگذارید.
نمونه Python در مستندات ارائهشده از gemini-3.8-flash استفاده میکند و برای همان نمونه، نسخه SDK بالاتر از ۲ لازم دانسته شده است. این مشخصات متعلق به نمونه API است؛ نه نشانه دسترسی شما به مدل در برنامه Gemini. پیش از اجرا، دسترسی مدل و سازگاری محیط خود را با مستندات بررسی کنید.
اگر بعداً درخواست تولید پاسخ فرستادید، اطلاعات usage را در بخش جداگانهای ذخیره کنید. count_tokens اندازه ورودی پیش از اجرا را میسنجد، اما usage دستههای مصرف پس از اجرا را گزارش میکند؛ این دو را یک ستون واحد در نظر نگیرید.
نتیجه را اصلاح، ذخیره و عیبیابی کنید
۷) اگر دو نتیجه متفاوتاند، ابتدا متن دقیق، فاصلهها، نیمفاصلهها، نشانهگذاری و مدل یا رمزگذاری را مقایسه کنید. برای بررسی اثر یک تغییر، فقط همان ویژگی را عوض کنید؛ مثلاً علامت پایان جمله را تغییر دهید و دوباره بشمارید.
۸) فایل را با قالب متنی UTF-8 ذخیره کنید تا متن فارسی و نتیجهها کنار هم باقی بمانند. کنار هر عدد، روش اندازهگیری را نگه دارید؛ عدد بدون متن و مشخصات مدل، برای مقایسه بعدی کافی نیست.
اگر شمارش متن ساده با مصرف گزارششده درخواست برابر نبود، لزوماً اشتباهی رخ نداده است. راهنمای OpenAI توضیح میدهد که ساختار پیام، ابزارها و فایلها میتوانند ورودی درخواست را تغییر دهند. پاسخ قابلمشاهده کوتاه نیز الزاماً مصرف خروجی کمی ندارد، چون ممکن است توکنهای استدلال نمایش داده نشوند.
در نهایت، تعداد توکن متن را با سقف زمینه اشتباه نگیرید: اولی اندازه ورودی شماست و دومی محدودیت مدل. مستندات Gemini برای سقف زمینه به مشخصات مدلها ارجاع میدهد؛ یک سقف مشترک برای همه مدلها فرض نکنید.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.