تست کد تولیدشده با هوش مصنوعی با یک تمرین کوچک پایتون
با یک تابع تبدیل ارقام فارسی، قرارداد رفتار بنویسید، آزمونهای unittest را محلی اجرا کنید و تفاوت تأیید مدل با شواهد واقعی اجرای کد را ببینید.
در این مقاله میخوانید ۶ بخش
درستی کد را با اجرا بررسی کنید، نه با اطمینان مدل
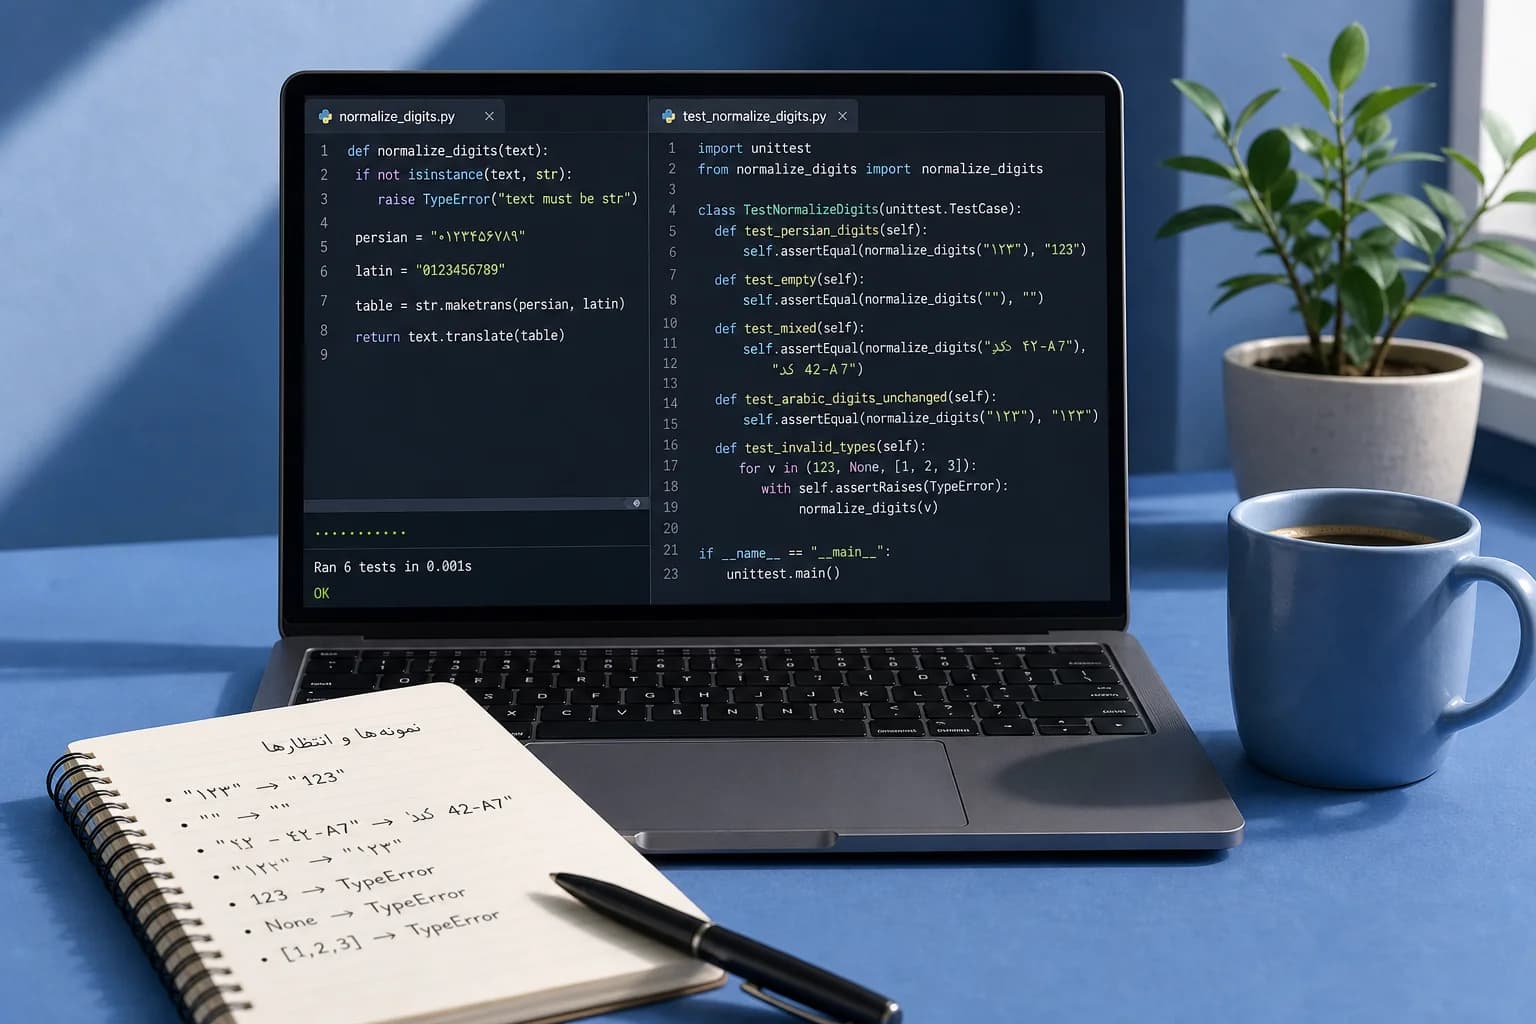
برای تست کد تولیدشده با هوش مصنوعی، ابتدا رفتار مورد انتظار را مشخص کنید و سپس خروجی واقعی را با آزمونهای محلی بسنجید. در این تمرین، یک تابع تبدیل ارقام فارسی به لاتین و فایل آزمون مستقل میسازیم؛ نتیجه قابل تحویل، دو فایل پایتون و گزارش اجرای آزمونهاست.
مستندات GitHub هشدار میدهند که کد پیشنهادی ممکن است درست به نظر برسد، اما از نظر نحوی، معنایی یا برآوردهکردن نیاز کاربر نادرست باشد. بازبینی هوش مصنوعی هم همه مشکلات را پیدا نمیکند. بنابراین جمله «این کد درست است» از همان مدل یا مدلی دیگر، جای اجرای آزمون را نمیگیرد.
کدهای زیر نمونه آموزشی پیشنهادیاند، نه گزارش آزمایش عملی یا تضمین صحت. دامنه تمرین را عمداً به تابعی بدون شبکه و بدون خواندن یا نوشتن فایل محدود میکنیم؛ این محدودیت تضمین امنیت نیست.
۱. محیط و قرارداد تابع را آماده کنید
به Python 3، یک ویرایشگر متن، ترمینال و ابزار تولید کدی که اکنون به آن دسترسی دارید نیاز دارید. این تمرین به اشتراک یا API مشخصی وابسته نیست؛ دسترسی به ابزار انتخابی تابع شرایط همان سرویس است. نام مدل و نسخه اعلامشده در رابط، تاریخ درخواست و نسخه پایتون خود را یادداشت کنید. اگر نسخه مدل نمایش داده نمیشود، آن را «نامشخص» ثبت کنید، نه اینکه حدس بزنید.
unittest بخشی از کتابخانه استاندارد پایتون است و برای این تمرین بسته آزمون جداگانهای لازم نیست. منبع ارائهشده، مستندات این ماژول در نسخه مشاهدهشده Python 3.15.0 است؛ این عدد الزام نصب همان نسخه نیست.
پیش از درخواست کد، قرارداد را بنویسید: تابع normalize_digits فقط رشته میپذیرد؛ ارقام «۰۱۲۳۴۵۶۷۸۹» را به «0123456789» تبدیل میکند؛ سایر نویسهها، فاصلهها و نشانهها را حفظ میکند؛ رشته خالی را خالی برمیگرداند؛ و برای ورودی غیررشتهای TypeError ایجاد میکند. این قرارداد انتخاب آموزشی ماست، نه رفتاری که باید از نام تابع حدس زد.
۲. نمونهها را قبل از تولید کد تعیین کنید
انتظارها را از قبل ثبت کنید: «۱۲۳» باید «123» شود؛ رشته خالی باید خالی بماند؛ «کد ۴۲-A7» باید «کد 42-A7» شود. برای بررسی حفظ سایر نویسهها، «١٢٣» با ارقام عربی باید بدون تغییر بماند؛ قرارداد ما فقط ارقام فارسی را پوشش میدهد. عدد 123، مقدار None و یک فهرست نیز باید TypeError بدهند، نه اینکه خودکار به رشته تبدیل شوند.
نمونه پرامپت پیشنهادی، نه نتیجه تضمینشده:
«برای Python 3 تابع normalize_digits(text) بنویس. فقط رشته بپذیر و برای ورودی غیررشتهای TypeError ایجاد کن. فقط ارقام فارسی ۰۱۲۳۴۵۶۷۸۹ را به 0123456789 تبدیل کن و بقیه نویسهها را حفظ کن. از شبکه، عملیات فایل و بسته شخص ثالث استفاده نکن. پیادهسازی را برای normalize_digits.py و آزمونهای unittest را جداگانه برای test_normalize_digits.py بده. آزمونها باید ورودی عادی، خالی، ترکیبی، ارقام عربیِ بدون تغییر و ورودی غیررشتهای را پوشش دهند. ادعای اجرای آزمون نکن؛ فرمان اجرای محلی را ارائه کن.»
انتظارهای مستقل، احتمال پذیرفتن همان برداشت نادرست در کد و آزمون تولیدشده را کمتر میکنند؛ بااینحال خود آزمونها نیز باید خوانده شوند.
۳. کد و آزمونها را در دو فایل ذخیره کنید
پیش از اجرا، خروجی مدل را بخوانید: آیا ورودی را بیاجازه به رشته تبدیل میکند؟ آیا ارقام بیشتری را تغییر میدهد؟ آیا فرمان یا وابستگی غیرضروری اضافه کرده است؟ مستندات GitHub درباره پیامد اجرای فرمانهای پیشنهادی هشدار میدهند.
نمونه پیشنهادی برای normalize_digits.py:
def normalize_digits(text): if not isinstance(text, str): raise TypeError("text must be a string") table = str.maketrans("۰۱۲۳۴۵۶۷۸۹", "0123456789") return text.translate(table)
نمونه آزمون برای test_normalize_digits.py:
import unittest from normalize_digits import normalize_digits
class NormalizeDigitsTests(unittest.TestCase): def test_persian_digits(self): self.assertEqual(normalize_digits("۰۱۲۳۴۵۶۷۸۹"), "0123456789")
def test_empty(self): self.assertEqual(normalize_digits(""), "")
def test_mixed(self): self.assertEqual(normalize_digits("کد ۴۲-A7"), "کد 42-A7")
def test_other_characters(self): self.assertEqual(normalize_digits("١٢٣ !"), "١٢٣ !")
def test_invalid_inputs(self): for value in (123, None, []): with self.subTest(value=value): with self.assertRaises(TypeError): normalize_digits(value)
هر دو فایل را در یک پوشه ذخیره کنید و تورفتگی کد را حفظ کنید. در unittest، assertEqual خروجی را با انتظار مقایسه میکند و assertRaises وقوع استثنای تعیینشده را میسنجد.
۴. آزمونها را اجرا کنید و شکست را به اصلاح تبدیل کنید
ترمینال را در همان پوشه باز کنید و این فرمان را اجرا کنید:
python -m unittest discover -v
کشف خودکار unittest بهطور پیشفرض فایلهای مطابق test*.py را جستوجو میکند؛ گزینه -v جزئیات بیشتری نشان میدهد. گزارش را تا پایان بخوانید و تعداد واقعی آزمونهای اجراشده و شکستها را ثبت کنید.
اگر خروجی «۱۲۳» با انتظار «123» برابر نیست، پیادهسازی تبدیل را بررسی کنید. اگر آزمون ورودی نامعتبر شکست خورد، ببینید تابع بهجای ایجاد TypeError ورودی را به رشته تبدیل کرده است یا نه. متن خطا، ورودی و انتظار را به مدل بدهید و درخواست اصلاح محدود کنید؛ انتظار آزمون را صرفاً برای سبزشدن نتیجه تغییر ندهید.
پس از هر اصلاح، کل مجموعه را دوباره اجرا کنید. اگر قرارداد واقعاً تغییر کرد، ابتدا آن را روشن کنید و سپس آزمونهای مرتبط را بهروز کنید.
۵. مشکل اجرا و حدود نتیجه را بشناسید
اگر صفر آزمون اجرا شد، این موفقیت نیست. نام test_normalize_digits.py، پوشه اجرای فرمان و نام روشهای آزمون با پیشوند test را بررسی کنید. اگر ماژول پیدا نمیشود، مطمئن شوید هر دو فایل در همان پوشهاند و نام فایل پیادهسازی با import مطابقت دارد.
برای تحویل نتیجه، دو فایل را همراه قرارداد، مشخصات مدل و پایتون، فرمان اجرا و گزارش واقعی ترمینال نگه دارید. گزارش را خودتان از اجرای محلی بردارید؛ متن تولیدشده توسط مدل شاهد اجرا نیست.
قبولی این مجموعه فقط رفتارهای بررسیشده را پوشش میدهد. میتوانید بر اساس نیاز واقعی آزمونهای تازه اضافه کنید، اما هیچ تعداد محدودی از آزمونها بهتنهایی نبود خطا یا امنیت کد را تضمین نمیکند. همچنین برای گرفتن کمک، اطلاعات محرمانه را وارد پرامپت یا گزارش خطا نکنید؛ این تمرین به داده حساس نیاز ندارد.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.