چرا هوش مصنوعی اطلاعات غلط میدهد، حتی وقتی مطمئن به نظر میرسد؟
پاسخ روان یا توضیح مرحلهبهمرحله، درستی اطلاعات را ثابت نمیکند. با دو پژوهش و یک تمرین ساده، ادعاهای قابل بررسی را از توضیح قانعکننده جدا کنید.
در این مقاله میخوانید ۵ بخش
روانی پاسخ با درستی آن فرق دارد
چرا هوش مصنوعی اطلاعات غلط میدهد؟ پاسخ کوتاه این است که توانایی تولید متنِ پذیرفتنی، تضمین درستی تکتک ادعاهای آن نیست. مدل میتواند جملهای منسجم بسازد، اما برای یک نام، تاریخ یا نسبت مشخص اطلاعات کافی نداشته باشد. لحن مطمئن هم بهتنهایی شاهد محسوب نمیشود.
OpenAI در توضیح پژوهشی منتشرشده در ۵ سپتامبر ۲۰۲۵، «توهم» را پاسخ ظاهراً پذیرفتنی اما نادرست توصیف میکند. پژوهش آنتروپیک در ۲۷ مارس ۲۰۲۵ نیز نشان میدهد که در نمونههای بررسیشده، حتی توضیح مرحلهبهمرحله لزوماً بازتاب وفادار محاسبات داخلی مدل نیست.
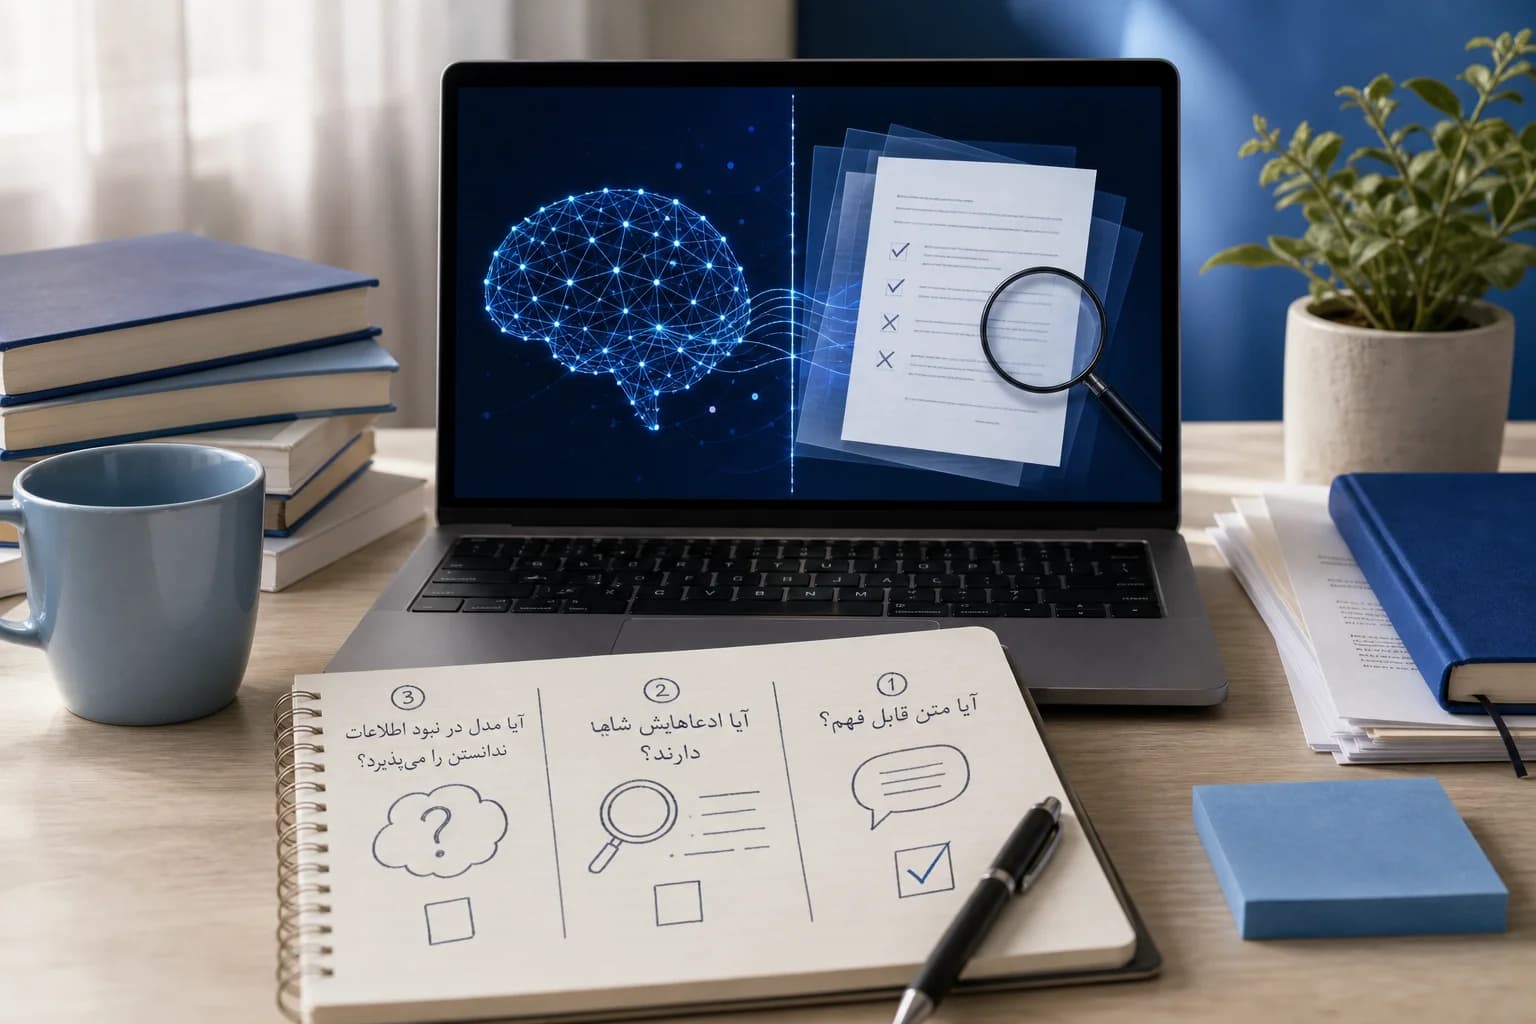
برای خواندن پاسخها، سه پرسش را جدا نگه دارید: آیا متن قابلفهم است؟ آیا ادعاهایش شاهد دارند؟ آیا مدل در نبود اطلاعات، ندانستن را میپذیرد؟ پاسخ مثبت به پرسش اول، پاسخ دو پرسش دیگر را تعیین نمیکند.
یادگرفتن زبان، همان یادگرفتن حقیقت نیست
طبق توضیح OpenAI، مدل در پیشآموزش الگوهای ادامه متن را یاد میگیرد؛ اما جملههای داده آموزشی معمولاً برچسب جداگانه «درست» یا «غلط» ندارند. بنابراین یادگیری نظم زبان با دانستن یک واقعیت کمتکرار و دلبخواهی، مانند تاریخ تولد فردی مشخص، یکسان نیست.
این منبع، مبتنی بر پژوهش نویسندگان OpenAI و Georgia Tech، نقش مشوقهای ارزیابی را هم برجسته میکند. اگر پاسخ درست امتیاز بگیرد ولی «نمیدانم» امتیازی نداشته باشد، حدسزدن میتواند نمره را بالا ببرد و همزمان خطاهای بیشتری بسازد.
پیشنهاد پژوهش، سنجش جداگانه پاسخ درست، پاسخ غلط و خودداری از پاسخ است. این چارچوب توضیحی مهم است، اما نباید آن را اثباتِ وجود یک علت واحد برای تمام خطاهای تمام مدلها دانست.
پژوهش کلود چه چیز متفاوتی را بررسی کرد؟
آنتروپیک بهجای تمرکز بر امتیازدهی، بخشی از محاسبات داخلی Claude 3.5 Haiku را با روش ردیابی مدارهای محاسباتی بررسی کرد. در نمونههای مطالعهشده، پژوهشگران سازوکاری برای اعلام کمبود اطلاعات یافتند که فعالبودنش میتوانست جلوی حدسزدن را بگیرد. مهار نامناسب همین سازوکار ممکن بود به پاسخ ساختگی منجر شود.
این دو توضیح لزوماً رقیب نیستند: پژوهش OpenAI درباره مشوقهای یادگیری و ارزیابی صحبت میکند؛ پژوهش آنتروپیک سازوکارهای داخلی یک مدل مشخص را بررسی میکند. یکی میپرسد «چه چیزی حدسزدن را تشویق میکند؟» و دیگری بخشی از مسیر محاسباتی پاسخدادن را دنبال میکند.
هر دو، پژوهشهای خود سازندگاناند، نه ارزیابی مستقل. روش آنتروپیک نیز فقط بخشی از محاسبات را آشکار میکند و ممکن است آثار مصنوعی ابزار پژوهشی را نشان دهد. نتایج Claude 3.5 Haiku و تکالیف ساده بررسیشده را نباید به همه چتباتها یا نسخههای فعلی تعمیم داد.
تمرین: پاسخ را به ادعاهای قابل بررسی تبدیل کنید
تمرین تألیفی زیر برای خواندن انتقادی پاسخهاست؛ گزارش آزمایش عملی یا تضمین نتیجه نیست. پیشنیاز آن فقط یک پاسخ متنی و منابعی است که بتوانید با آنها ادعاها را مقایسه کنید.
۱. از پاسخ، گزارههای مشخص را بیرون بکشید: نام مدل، تاریخ انتشار، نتیجه پژوهش و دامنه کاربرد نتیجه. جملهای مانند «این پژوهش بسیار مهم است» را از ادعای قابل بررسی جدا کنید.
۲. هر گزاره را در یکی از سه دسته قرار دهید: «دارای شاهد»، «بدون شاهد» یا «نیازمند توضیح بیشتر». بدون شاهد بودن الزاماً به معنی غلط بودن نیست؛ یعنی در مواد موجود، پشتیبانی کافی برای آن ندارید.
۳. دامنه شاهد را بررسی کنید. برای مثال، ادعای «آنتروپیک Claude 3.5 Haiku را بررسی کرده» در منبع پشتیبانی دارد؛ اما «همه مدلهای فعلی دقیقاً همین سازوکار را دارند» از این پژوهش نتیجه نمیشود.
پرامپت پیشنهادی و تألیفی: «در متن زیر، ادعاهای قابل بررسی را جدا کن. برای هر ادعا، شاهد موجود در منابعی را که همراه متن میدهم مشخص کن. اگر شاهدی نیست، بنویس بدون شاهد؛ اگر دامنه ادعا مبهم است، بنویس نیازمند توضیح بیشتر. توضیح قانعکننده را بهجای شاهد نپذیر.»
خروجی این درخواست را نیز باید با منابع مقایسه کنید؛ توضیح تازه مدل، بهخودیخود اعتبار ادعای قبلی را ثابت نمیکند.
وقتی نتیجه مبهم است، چه چیزی را اصلاح کنیم؟
اگر یک ادعا چند بخش دارد، آن را بشکنید: درستبودن نام مدل، تاریخ و نتیجه پژوهش سه بررسی جداگانه است. اگر نتیجهای درباره «مدلها» نوشته شده، بپرسید کدام مدل، در چه تکلیفی و با چه محدودیتی بررسی شده است.
اگر مدل توضیحی طولانی میدهد ولی شاهد مشخصی ندارد، درخواست کنید بخشهای فاقد پشتوانه را حذف کند یا عدم قطعیت را روشن بنویسد. هدف، گرفتن متنی مطمئنتر نیست؛ هدف، روشنشدن مرز میان دانسته، حدس و ابهام است.
محصول نهایی تمرین میتواند یادداشتی سهستونی از ادعا، شاهد و وضعیت باشد. آنچه ارزش نگهداشتن دارد، مسیر قابل بررسی ادعاهاست، نه صرفاً لحن روان پاسخ.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.