خواندن بنچمارک هوش مصنوعی؛ چرا دو نمره MMLU هممعنا نیستند؟
با یک تمرین ساده، شرایط دو نمره تاریخی MMLU را ثبت کنید؛ تفاوت روش ارزیابی، اطلاعات نامعلوم و محدودیت مقایسه مدلهای هوش مصنوعی را بشناسید.
در این مقاله میخوانید ۵ بخش
نام آزمون یکسان است؛ آیا روش هم یکسان است؟
در خواندن بنچمارک هوش مصنوعی، نام یکسان آزمون برای مقایسه دو عدد کافی نیست. باید بدانیم سؤال چگونه به مدل داده شده، پاسخ چگونه استخراج شده و نمره چگونه محاسبه شده است.
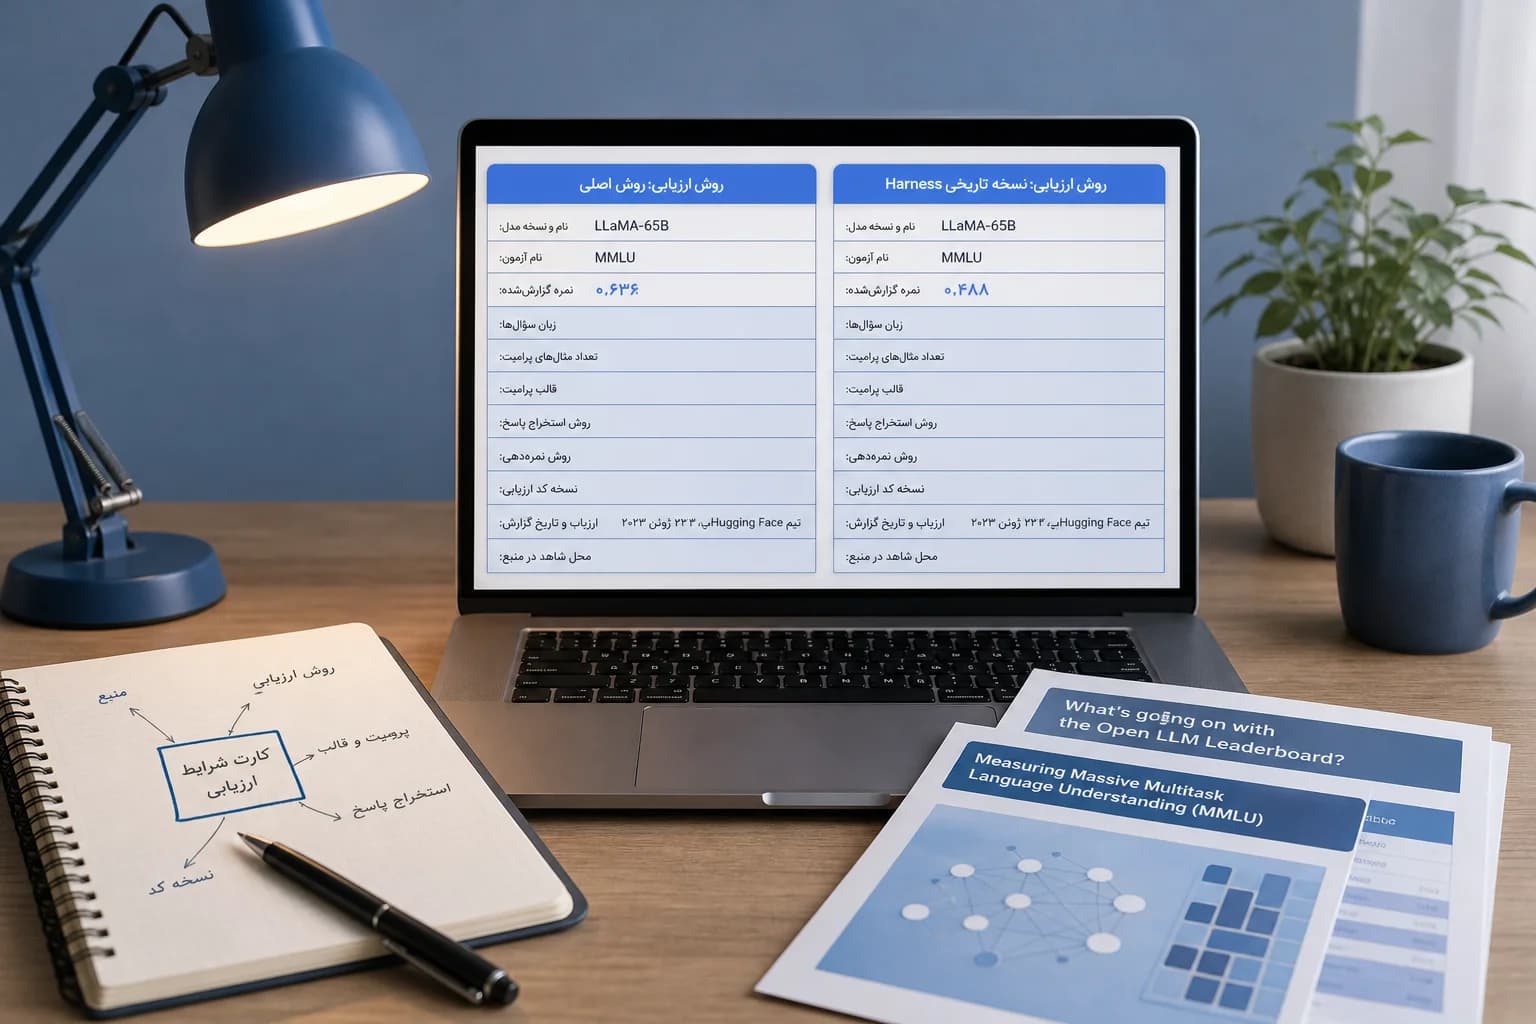
تیم Hugging Face در گزارش ۲۳ ژوئن ۲۰۲۳، سه پیادهسازی MMLU را با مجموعه سؤال یکسان بررسی کرد. در جدول تاریخی آن، مدل LLaMA‑65B با روش اصلی نمره ۰٫۶۳۶ و با نسخه تاریخی Harness نمره ۰٫۴۸۸ دارد. این دو عدد، نتیجه دو قرارداد ارزیابی متفاوتاند؛ نه شاهدی بر تغییر توانایی مدل میان دو نوبت استفاده.
در این تمرین، با مرورگر و ویرایشگر متن یک «کارت شرایط ارزیابی» میسازید. نیازی به اجرای مدل، حساب چتبات یا خرید اشتراک ندارید. خروجی، فایلی است که روشن میکند کدام مقایسه قابل دفاع است و کدام اطلاعات هنوز معلوم نیست.
۱. جدول تاریخی و معنای نمره را مشخص کنید
گزارش Hugging Face با عنوان What's going on with the Open LLM Leaderboard? را در مرورگر باز کنید و ردیف LLaMA‑65B را در جدول مقایسه روشها پیدا کنید. عنوان گزارش و تاریخ انتشار را کنار دو عدد ثبت کنید تا بعدها این جدول با رتبهبندی امروز اشتباه نشود.
برای فهم معنای آزمون، به پژوهش اصلی Measuring Massive Multitask Language Understanding، منتشرشده در ۷ سپتامبر ۲۰۲۰، مراجعه کنید. MMLU آزمونی متنی و چندگزینهای در ۵۷ حوزه، از ریاضی تا تاریخ و علوم رایانه است. نمره آن دقت انتخاب گزینه را تحت شرایط ارزیابی نشان میدهد؛ نه کیفیت تمام کارهایی که یک چتبات انجام میدهد.
پژوهش اصلی ارزیابی بدون مثال را از ارزیابی با چند مثال جدا میکند. در روش چندمثالی GPT‑3، تا پنج نمونه پاسخدار پیش از سؤال میآید و گزینه دارای بیشترین احتمال میان A تا D انتخاب میشود. این توضیح را خودکار به هر ردیف جدول یا هر مدل دیگری تعمیم ندهید.
۲. برای هر عدد یک کارت جدا بسازید
در ویرایشگر متن، قالب زیر را دو بار وارد کنید و هر نسخه را به یک روش ارزیابی اختصاص دهید:
نام و نسخه مدل: LLaMA‑65B نام آزمون: MMLU روش ارزیابی: روش اصلی / نسخه تاریخی Harness نمره گزارششده: ۰٫۶۳۶ / ۰٫۴۸۸ زبان سؤالها: تعداد مثالهای پرامپت: قالب پرامپت: روش استخراج پاسخ: روش نمرهدهی: نسخه کد ارزیابی: ارزیاب و تاریخ گزارش: تیم Hugging Face؛ ۲۳ ژوئن ۲۰۲۳ محل شاهد در منبع:
۳. هر خانه را فقط با شاهد منبع تکمیل کنید. گزارش Hugging Face تفاوتهایی مانند قالب پرامپت، افزودن عنوان سؤال، استخراج حرف پاسخ در برابر متن تولیدشده و محاسبه احتمال کل گزینه را بررسی میکند. همچنین شناسه نسخه کدهای Harness و HELM را ثبت کرده است؛ شناسه مربوط را از همان گزارش بردارید، نه از نسخه فعلی یک مخزن.
اگر اطلاعاتی را پیدا نکردید، بنویسید «گزارش نشده در بخش بررسیشده». خالیماندن یک خانه یا ندانستن زبان، تعداد مثالها و نسخه دقیق کد مجوز حدسزدن نیست. کنار هر خانه، محل شاهد را بنویسید تا کارت قابل بازبینی باشد.
۴. تفاوتها را علامت بزنید و نتیجه را محدود کنید
دو کارت را کنار هم بگذارید. تفاوت مدل، آزمون، زبان، مثالهای پرامپت، استخراج پاسخ یا نمرهدهی را مشخص کنید. هر مورد نامعلوم را نیز مانع یک نتیجهگیری قطعی بدانید؛ برابر بودن خانههای معلوم، برابر بودن همه شرایط را ثابت نمیکند.
برای این نمونه، جمعبندی مناسب چنین است: «در گزارش تاریخی Hugging Face، یک مدل روی MMLU با دو پیادهسازی متفاوت نمرههای متفاوت گرفته است؛ بنابراین این دو عدد را نباید نتیجه یک پروتکل واحد معرفی کرد.» خود گزارش تغییر رتبه مدلها با تغییر روش را نیز نشان میدهد.
تمرین پیشنهادی تحریریه: «برای دو نمره MMLU، شرایط محاسبه را ثبت کن و تفاوتها را مشخص کن؛ داده نامعلوم را حدس نزن.» این دستور برای ساماندادن تمرین است، نه تضمین صحت خروجی یک ابزار هوش مصنوعی.
کارت را با برگشتن به شاهدها اصلاح کنید. اگر برای خواندن گزارش از خلاصه تولیدشده با مدل استفاده میکنید، راستیآزمایی خلاصه هوش مصنوعی را جداگانه انجام دهید؛ خلاصه جای شاهد اصلی نیست.
۵. فایل نهایی را ذخیره کنید و خطاهای رایج را رفع کنید
دو کارت و جمعبندی مقایسه را در یک فایل متنی با نامی مانند mmlu-evaluation-card.txt ذخیره کنید. عنوان و تاریخ منابع، محل شاهدها و خانههای نامعلوم را نگه دارید؛ فقط دو نمره را صادر نکنید.
اگر جدول فقط عدد دارد، بخش روش ارزیابی را بخوانید. اگر نسخه کد پیدا نمیشود، آن را نامعلوم بگذارید و محدودیت بازتولید را ثبت کنید. اگر میخواهید از میانگین کلی درباره همه موضوعها نتیجه بگیرید، به تفاوت عملکرد حوزهها توجه کنید؛ پژوهش اصلی محدودیت میانگین را نشان میدهد.
دو محدودیت دیگر هم باقی میماند: دیدن سؤال و پاسخ در پیشآموزش میتواند ارزیابی را مخدوش کند، اما بررسی آلودگی داده در مقاله اصلی محدود به همان مطالعه است. همچنین این منابع کیفیت پاسخ فارسی مدلهای امروز را نمیسنجند. محصول این تمرین، تشخیص شرایط مقایسه است؛ نه معرفی برنده عمومی یا رتبهبندی مدلهای سال ۲۰۲۶.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.