مدلهای pplx-embed-v2-late پرپلکسیتی برای جستوجوی متن و تصویر منتشر شدند
پرپلکسیتی دو مدل بازیابی متن و تصویر معرفی کرده است؛ تفاوت نسخههای 0.6b و 9b، مجوز MIT نسخه بزرگ و محدودیت شواهد عملکرد آنها را بخوانید.
در این مقاله میخوانید ۲ بخش
دو نسخه برای بازیابی اسناد، نه چتبات
پرپلکسیتی در اطلاعیه ۷ اکتبر ۲۰۲۶، مدلهای pplx-embed-v2-late پرپلکسیتی را در دو نسخه 0.6b و 9b برای بازیابی متن و تصویر معرفی کرد. این مدلها برای یافتن محتوای مرتبط طراحی شدهاند، نه تولید پاسخ مانند چتبات.
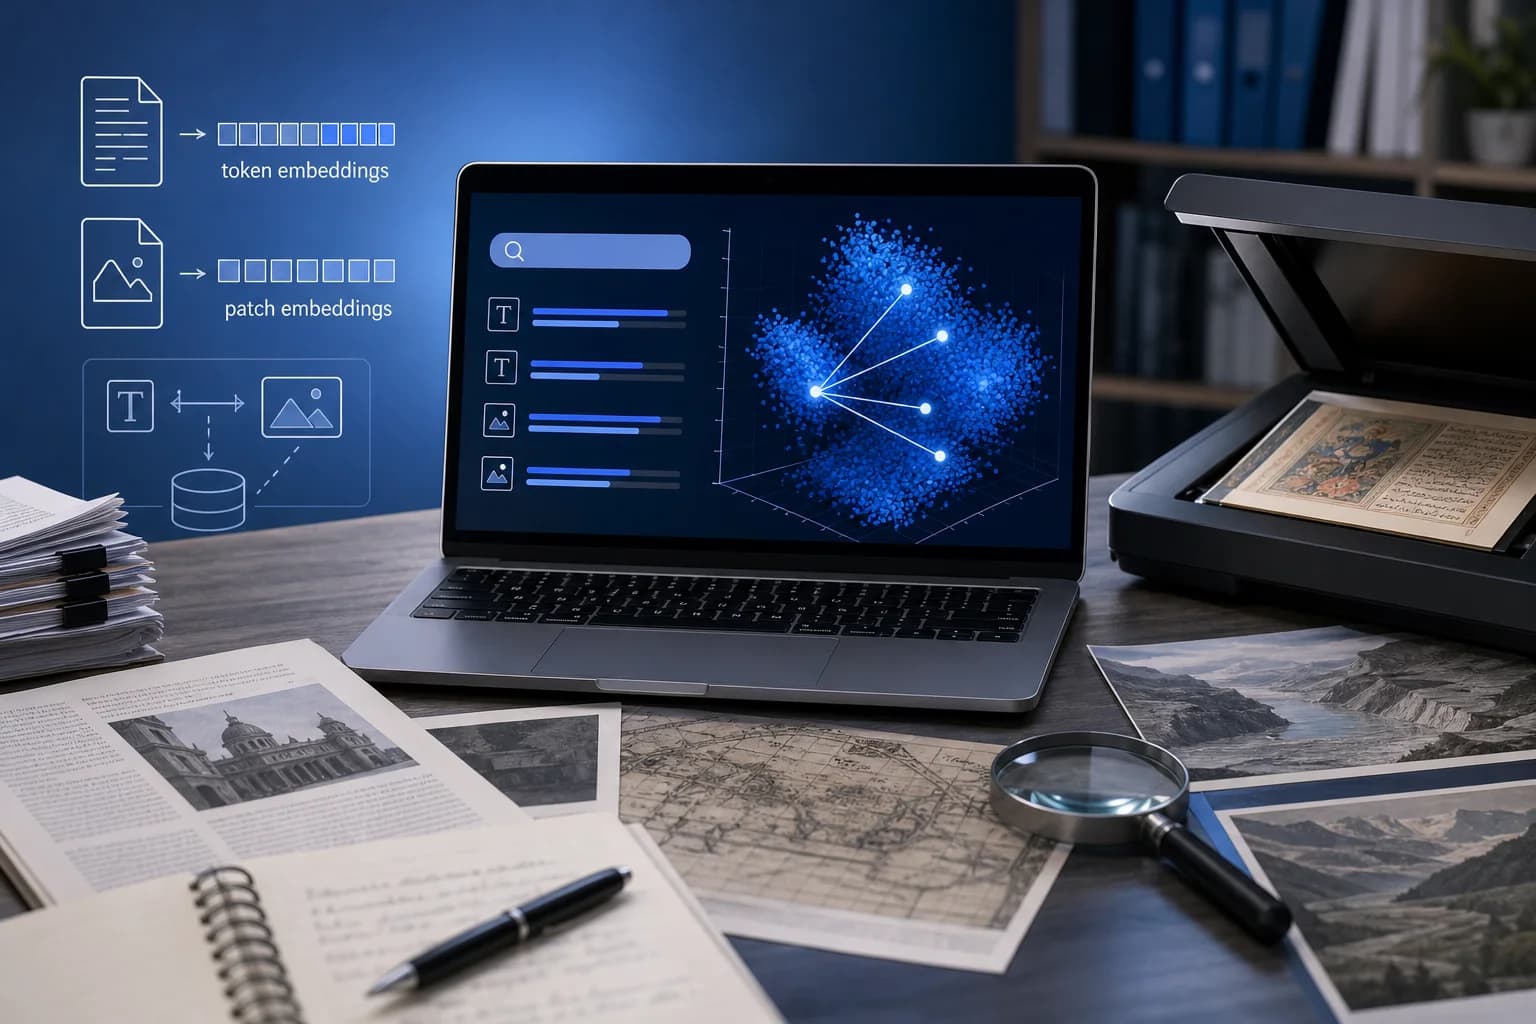
بهگفته شرکت، بهجای خلاصهکردن کل ورودی در یک بردار عددی، برای توکنها بردارهای جداگانه نگه داشته میشود تا بخشهای پرسش با بخشهای مختلف سند مقایسه شوند. پرپلکسیتی جستوجو در صفحات تصویری PDF بدون استخراج متن یا OCR را از کاربردهای این روش میداند.
دو نسخه فضای بردارسازی مشترک دارند؛ بنابراین نسخه کوچکتر میتواند پرسش را برای جستوجو در نمایهای پردازش کند که نسخه بزرگتر ساخته است. این قابلیت بهخودیخود کاهش هزینه یا کیفیت بهتر را تضمین نمیکند.
مجوز، دسترسی و معنای امتیازهای اعلامشده
کارت رسمی نسخه 9b در Hugging Face، وزنهای قابل دریافت، مجوز MIT و نمونه اجرای محلی را ارائه میکند. این عرضه را نباید با اضافهشدن قابلیت به برنامه مصرفکننده پرپلکسیتی یا دسترسی عمومی API یکی دانست. طبق کارت مدل، دستههای متن و تصویر باید جدا پردازش شوند؛ ورودی ترکیبی متنـتصویر پشتیبانی نمیشود.
در ارزیابی خود پرپلکسیتی روی بخش تصویری ViDoRe v3، امتیاز nDCG@10 نسخه کوچک ۶۲٫۳ درصد و نسخه بزرگ ۶۵٫۲ درصد گزارش شده است. این معیار کیفیت رتبهبندی نتایج بازیابی را میسنجد، نه درصد پاسخهای درست چتبات. منابع ارائهشده ارزیابی مستقل یا نتیجه مشخصی برای زبان فارسی ندارند.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.