مدل چندوجهی Clef-omni کلادفلر معرفی شد؛ تصمیمگیری با صدا و ویدیو
کلادفلر Clef-omni را برای تصمیمگیری با متن، تصویر، صدا و ویدیو معرفی کرد. سازوکار خروجی احتمالی، محدودیت ورودی و تعرفه Workers AI را بشناسید.
در این مقاله میخوانید ۲ بخش
به گزینهها احتمال میدهد، نه پاسخ آزاد
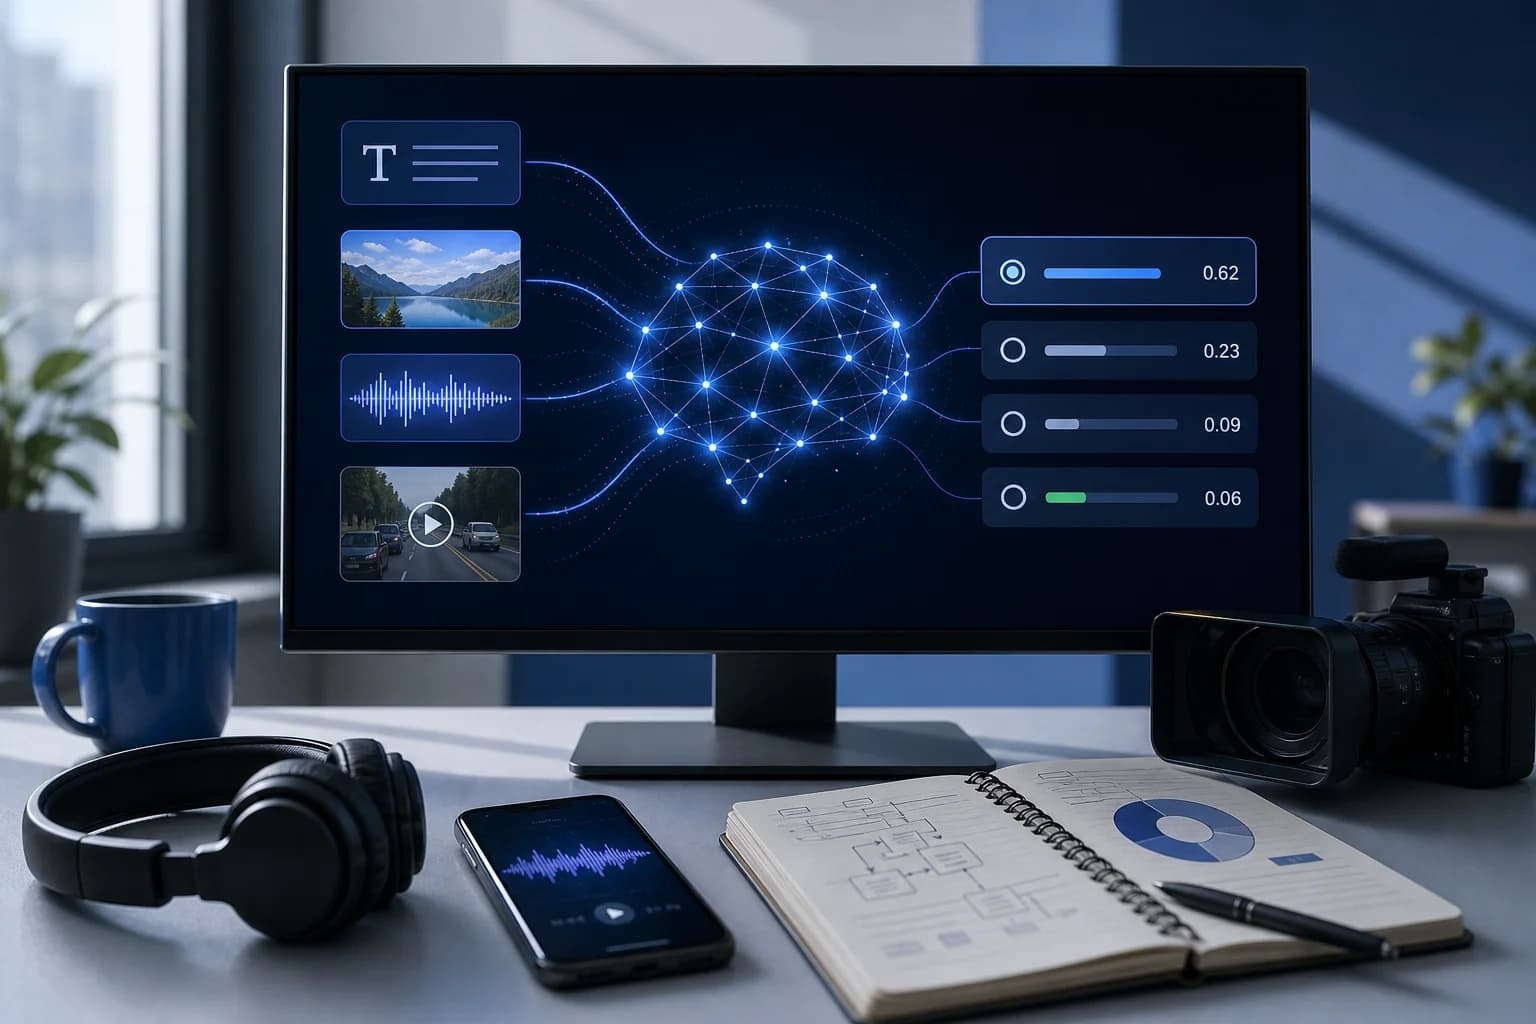
کلادفلر در اطلاعیه ۹ اکتبر ۲۰۲۶، مدل چندوجهی Clef-omni کلادفلر را معرفی کرد؛ مدلی برای تصمیمگیری که علاوه بر متن و تصویر، ورودی صوتی و ویدیویی میپذیرد. فایلهای WAV و MP3 برای صدا و MP4 و WebM برای ویدیو از قالبهای اعلامشدهاند.
تفاوت مهم آن با مدلهای پاسخگو، شکل درخواست و خروجی است: توسعهدهنده وضعیت کار، پرسشها و گزینههای مجاز را مشخص میکند و مدل به این گزینهها احتمال اختصاص میدهد، نه اینکه پاسخی آزاد بنویسد. این سازوکار برای کارهایی مانند دستهبندی و مسیریابی دادههای چندرسانهای کاربرد دارد؛ البته احتمال بالاتر، تضمین درستی تصمیم نیست.
کلادفلر انتشار وزنها در Hugging Face و دسترسی از طریق Workers AI را اعلام کرده است. این عرضه مربوط به مدل و زیرساخت توسعهدهندگان است، نه معرفی یک برنامه مصرفکننده.
ظرفیت ورودی و هزینه در Workers AI
طبق مستندات Workers AI، شناسه مدل @cf/cloudflare/clef-omni است و پنجره زمینه آن ۶۴ هزار توکن ظرفیت دارد. هر درخواست حداکثر چهار قطعه صوت و دو ویدیو میپذیرد؛ متن، پرسشها و رسانهها همگی از همین ظرفیت استفاده میکنند. پرشدن ظرفیت ممکن است باعث شکست درخواست یا کوتاهشدن متن وضعیت شود.
تعرفه درجشده، ۰٫۱۵ دلار برای هر میلیون توکن ورودی است و توکن خروجی هزینه ندارد. جدولهای عملکرد منتشرشده نیز متعلق به خود کلادفلر هستند، نه ارزیابی مستقل؛ این نتایج برتری یکدست مدل تازه در همه کارها را نشان نمیدهند.
هنوز دیدگاهی منتشر نشده است. اولین نفر باشید.